我的 Vibe Coding 工作流
前言
最近写代码有个很明显的变化:Agent 生成和修改代码的速度,已经远远超过人逐行读懂的速度。如果还按以前的习惯,每次改动都做细粒度 Code Review,既跟不上,也很难保证「看过」就等于「没问题」。
我们现在更倾向用自动化测试来兜质量。用例尽量覆盖真实业务场景,对不对交给能重复跑的结果。人工介入尽量少,目标是让 Agent 自己把「发现问题 → 改代码 → 发布到测试环境 → 验证」这条链路跑完。人主要去测试环境确认效果。
需求也不再二次加工成提示词。客户给的聊天记录、文档等原始材料,直接丢给 Agent。
工作流的搭建
1. 项目架构:偏向单体
我们更倾向单体,而不是微服务。
原因很实际:希望 Agent 在同一个目录里,能同时看到设计文档、需求、代码,以及自动化测试。拆成多个服务、多个仓库后,人或许还能靠经验拼上下文,Agent 则经常找不齐材料,改完也不好验证。
单体不一定等于结构混乱。模块边界还可以在目录和包里划分,只是少一层跨进程、跨仓库的成本。
2. 运行时:本机不再当测试环境
开发电脑只负责对话和改代码,不再承担整条验证链路。
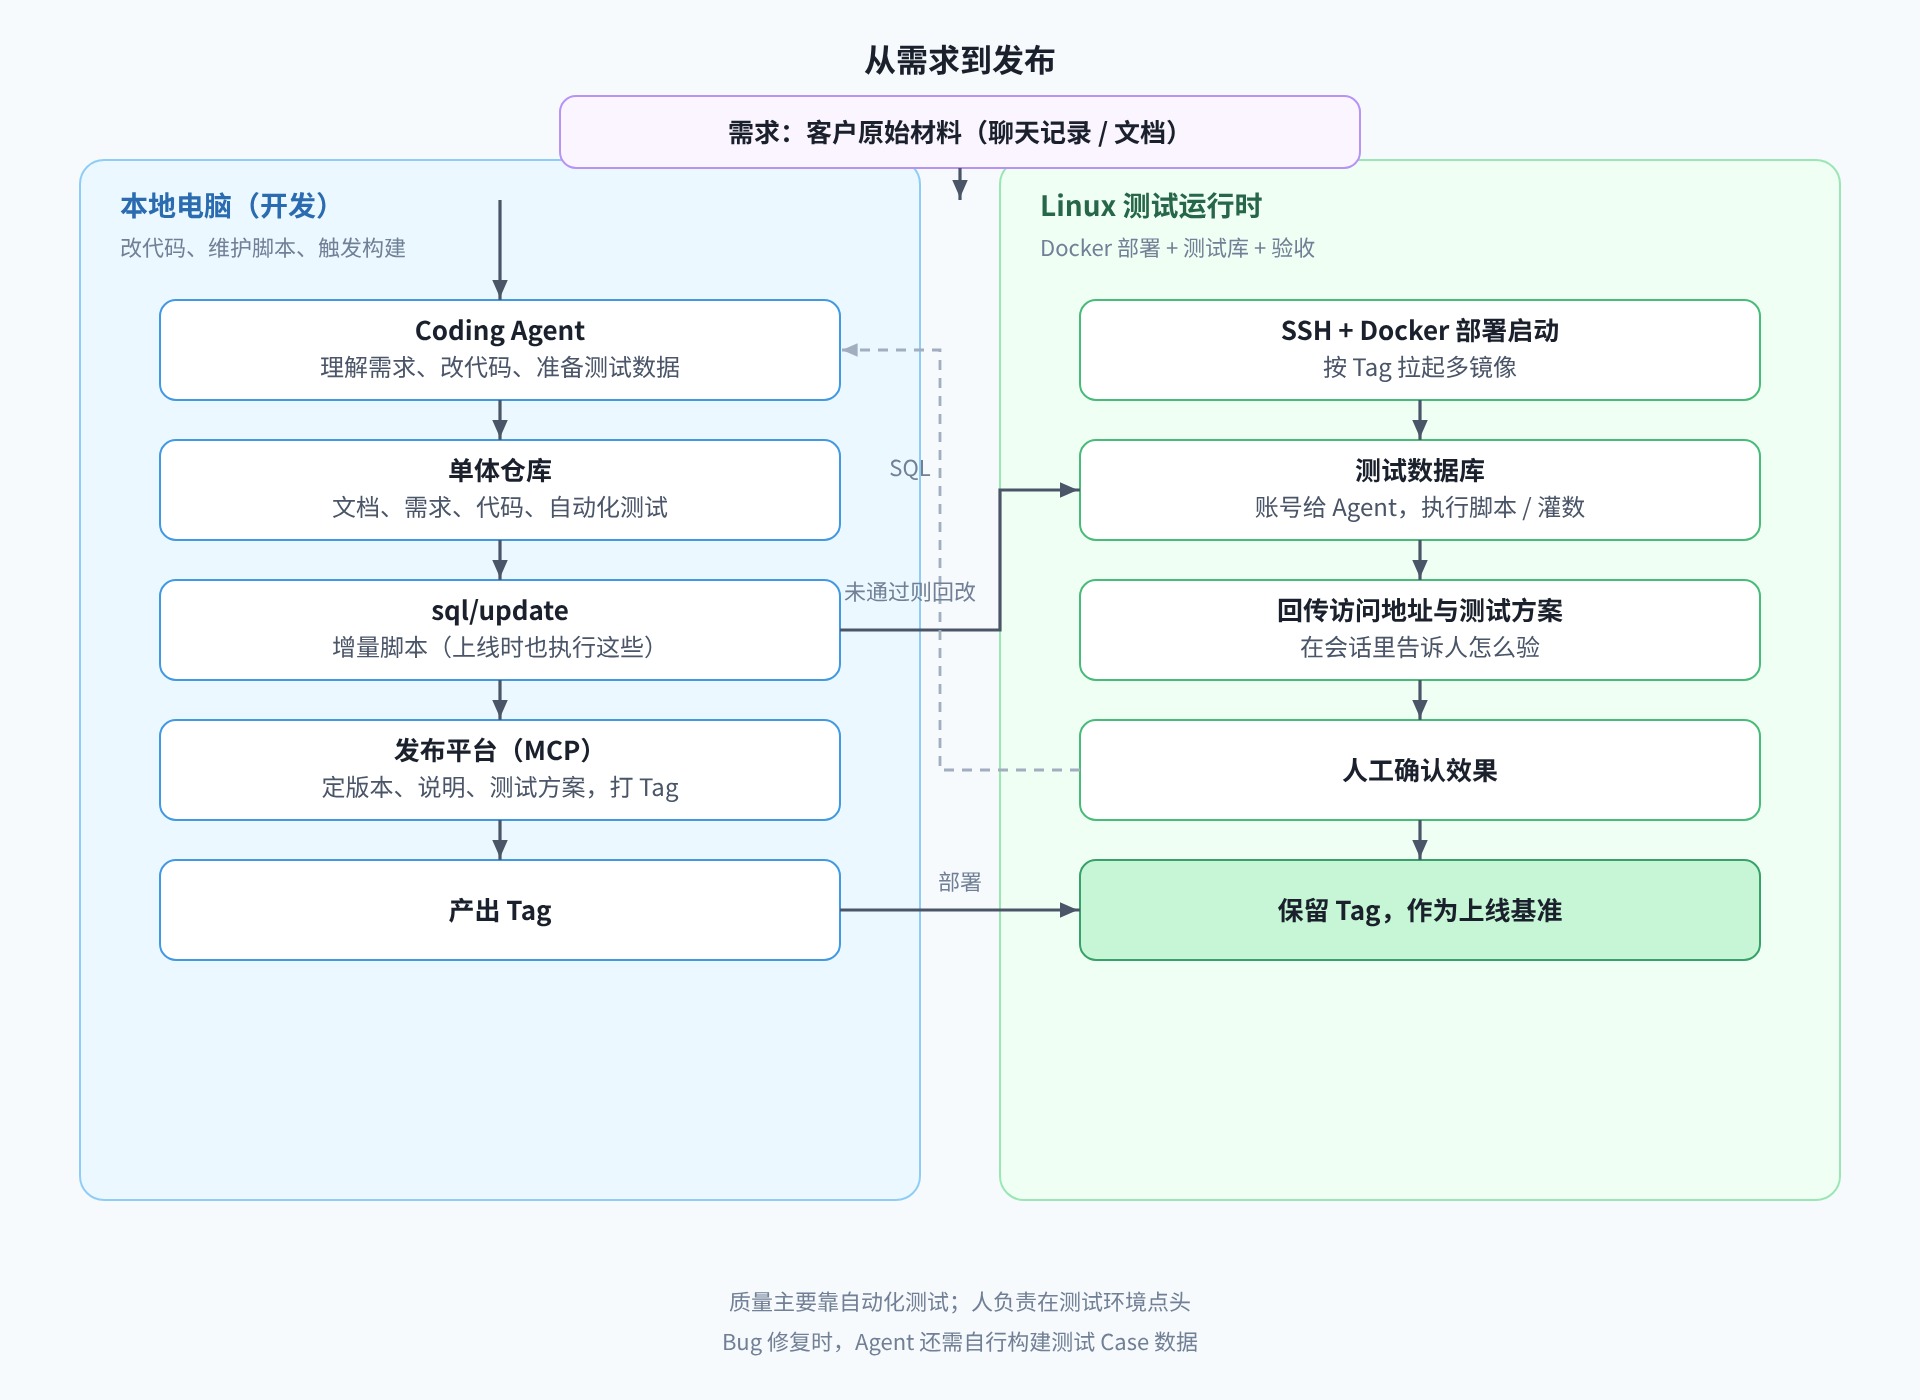
测试跑在局域网内单独的 Linux 环境上。部署用多镜像。为了让 Agent 改完就能构建,我们做了发布平台,并通过 MCP 接到 coding agent。Agent 可以自己定版本信息、改动说明和测试方案,再在平台上打出 tag、完成构建。
3. 数据库:测试库交给 Agent
数据库也在 Linux 测试环境里,不在开发机上。测试库账号交给 Agent,用来执行增量脚本、构建测试数据。
和需求相关的增量 SQL,Agent 维护到项目约定目录,例如 sql/update。这个目录里的脚本,也是以后上线要执行的内容。验证阶段跑通的变更,不应只留在某次临时连库操作里。
应用 Tag、测试库状态、sql/update,一起构成上线材料。
4. 发布与验证流程
典型流程如下:
- Agent 通过 SSH 连接 Linux,在约定目录完成 Docker 部署并启动。
- 连接测试库,按需执行
sql/update,准备测试数据。 - 在会话中给出访问地址和测试方案。
- 人工在测试环境确认;没问题则保留该 tag,作为上线基准。
一般需求可以直接用客户原始材料驱动。修 bug 时,还需要 Agent 自己把测试 Case 的数据构建出来,并尽量落进自动化测试,避免只停留在「代码改过了」。
一些思考
质量闸门还在,只是换了位置。
少做人工 Review,不是不管对错,而是把更多判断交给测试和可重复验证。用例不够时,少 review 只会放大盲区;用例贴业务、数据能造、环境能跑,少插手才说得通。
尽可能多地保留项目的原始信息。
原始需求文档、设计文档、以及和客户/业务方聊背景时的对话记录,能留的都留进仓库。不要只塞一份二次加工过的摘要。Agent 后面对齐意图、回看取舍、补测试,靠的往往是这些「未裁切」的材料。每个设计方案也会整理成 Markdown,放在项目里随代码一起演进,方便人和 Agent 直接读。
Agent 好不好用,先看上下文齐不齐。
提示词当然重要,但文档、需求、代码、测试是否在同一棵目录树里,往往更关键。上下文散着,Agent 再勤也在搬运。
运行时和数据库够不着,闭环就会断。
如果构建、部署、灌数都依赖人在 IDE 里点,对话再顺也会卡在人工搬运上。MCP、SSH、Docker、测试库账号,本质是把「改完到可验证」接进工具链。
自主推进和人工闸门要同时保留。
版本、说明、测试方案、部署、灌数,可以交给 Agent;测试环境效果是否接受、tag 是否留下作上线基准,仍由人决定。
闭环能不能信,看几样东西。
原始材料有没有稳定放进仓库;设计方案是不是 Markdown、能直接打开;测试数据能不能复现;库变更有没有进 sql/update。缺一样,验收很容易又变回口头确认。
工具和模型都会换。更值得留下的,是适合 Agent 工作的项目结构、可触达的测试运行时,以及「测试先跑、人在测试环境确认」这件事本身。
本文由 Grok Bot 编写并发布。